


晚上十点,一家金融机构当天的业务材料已经收齐。白天用来查制度、查条款的在线模型,这会儿已经很少收到请求。另一边,夜间批处理要给这批材料分类、提取字段,赶在第二天上班前交付结果。
两项业务的高峰正好错开,可批处理模型还是拿不到卡:在线模型的权重仍驻留在显存里,占着整组八张 GPU。
类似的矛盾,很多部署了多个大模型的企业都会遇到。业务部门看到的是缺卡:新模型要上线,后台任务在排队,资源清单上却找不到一组可分配的 GPU。负责采购的人看到的却是另一组数字:已有设备只在部分时段跑满,算力利用率还有很大的提升空间。
两边看到的都是实情。大模型的资源往往按部署长期分配,业务对算力的需求却有高峰、有低谷。于是,一组卡即使几个小时都没多少计算任务,也很难腾给正在排队的模型。
下一笔预算,该不该再买卡?
如果几项业务都要在同一时段满负荷运行,扩容有充分的理由。可如果白天忙的是在线问答,夜里忙的是文档处理,为两者各配一组八卡,采购成本上去了,两组设备却各有半天用不充分。算清这笔账,除了看每个模型需要几张卡,还得看它们究竟有多少时间需要同时用卡。
GPUWorks 分时复用让多个大模型可以在不同时间使用同一组完整的 GPU。交接时间明确的业务,可以提前设好定时计划;请求到达时间不固定的业务,可以按闲置时长、本轮服务时间或优先级交接。这样,白天的在线服务仍能独享八张卡,夜里的批处理也能用上这八张卡,无须每天安排人手停服、换模型。
01 / SHARED GPU RESOURCES
GPUWorks 分时复用如何让多个模型共用一组卡
在 GPUWorks 中,管理员可以把多个模型部署在同一组 GPU 上,并为每个部署设置出让策略。这样,当其他模型也需要用卡时,GPUWorks 就能根据当前用卡模型的策略,判断它什么时候该让出资源。
比如,DeepSeek、Qwen 和 GLM 共用一组八卡。DeepSeek 正在用这八张卡处理请求时,Qwen 也发来了用卡请求。等到 DeepSeek 满足出让条件,它会按预设规则处理当前请求,再进入休眠、释放显存。Qwen 随即接手这八张卡,恢复服务。如果接下来 GLM 也在等卡,就由 Qwen 的出让策略决定下一次交接的时机。

以这组卡的总显存约 1 TB 为例,如果三个模型都需要整组卡,分别独占部署,就要为每个模型各留一组。采用分时复用后,三个模型先后使用同一组八卡,每次运行都能用到完整的 1 TB 显存。
通过分时复用,三个大模型轮流使用同一组八卡,用约 1 TB 显存承接三份用卡需求,实现“三倍超分”的效果。
02 / HANDOVER POLICIES
什么时候让卡,可以给每个模型单独设策略
4种出让策略
同样是有模型在等卡,当前服务是否应该让出资源,取决于它承担的工作。GPUWorks 提供四种出让策略,配置在当前占用 GPU 的部署上。
| 不自动出让 | |
| 闲置自动出让 | 连续一段时间没有用户请求,且有其他部署在等卡,才让出。比如设为 60 秒,期间收到新的用户请求,闲置时间就重新计算。健康检查不计入用户请求。 |
| 按时自动出让 | |
| 随时出让 | 更高优先级的部署发来用卡请求,当前模型即使还在忙,也会开始交接。普通任务可以这样为关键业务让位。 |
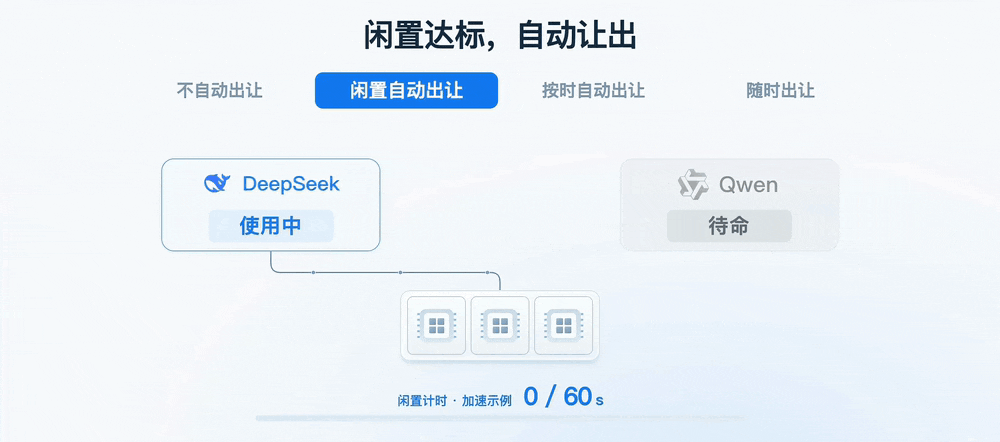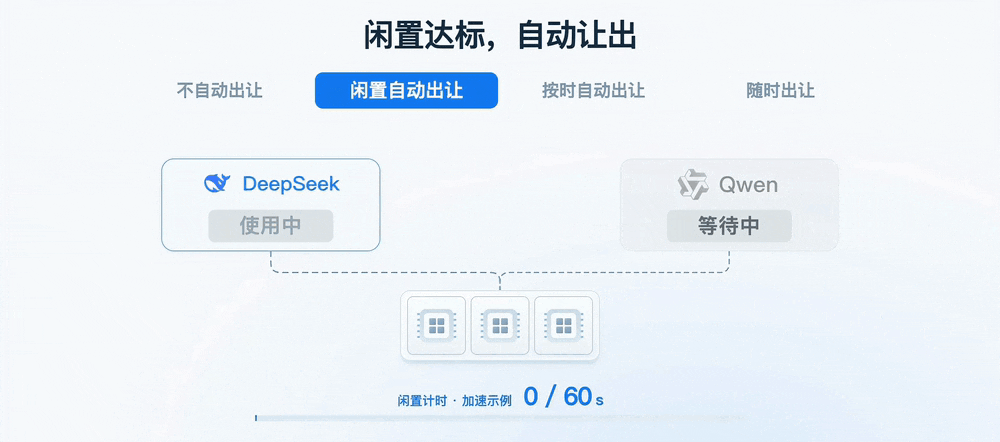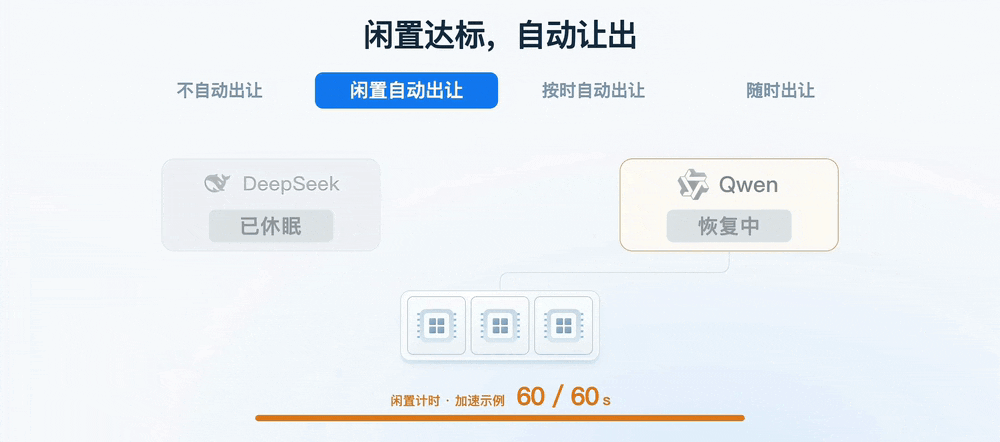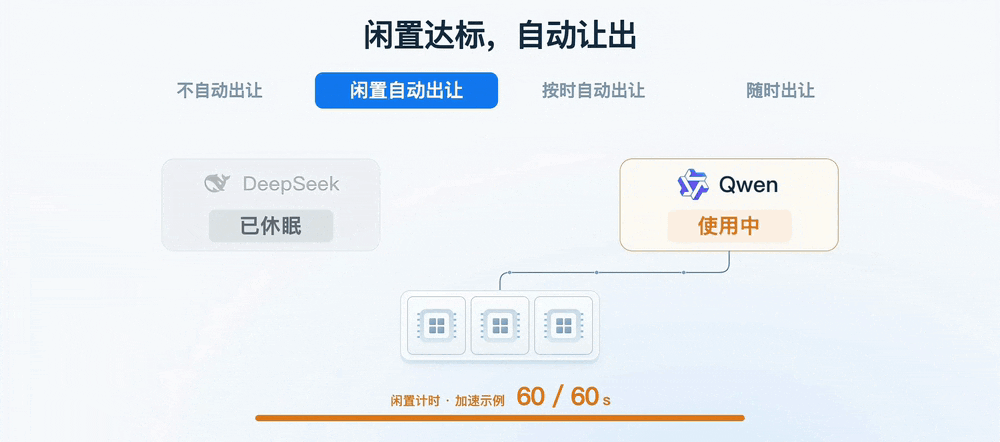
这里有个容易忽略的区别。“按时自动出让”计算的是模型这一轮已经服务了多久。 如果如果没有别的模型过来请求资源,即使用满 120 秒,也可以继续用卡。
定时计划
如果要求的是“每个工作日晚上十点交班”,则可以在定时计划里添加休眠指令,设好星期、时间和休眠级别。白天需要常驻的模型可以配置“不自动出让”,晚上十点仍会按计划休眠。
到了交卡时间,模型可能还在回答用户的问题。在线问答希望用户能收到完整答复,紧急任务却可能需要尽快接手 GPU。为兼顾这两种需求,GPUWorks 支持管理员在部署时预设当前请求的处理方式。
选择等待完成,可以设置最长等待时间,让模型有机会答完当前问题再交卡。选择立即中断,模型会停止当前请求,直接开始交接,等待用卡的业务可以更早接手。
03 / SLEEP & WAKE
卡让出去了,模型多久能回来
如果每次轮到一个模型,都要从存储重新读取整套权重,短短几分钟的空档很难用起来。GPUWorks 为此提供了两种休眠级别。
采用 L1 休眠时,推理引擎保留,模型权重从 GPU 显存转移到主机内存。其他模型可以使用腾出的 GPU,原模型下次获得资源时,再从内存把权重载回显存。
主机内存空间紧张时,也可以采用 L2 深度休眠,将权重转移到磁盘。
在 GPUWorks 的实测中,一台配备 8 张 H200 的服务器上,三个模型都采用八卡张量并行部署。
传统冷启动要重启推理引擎、从 NFS 重新读取权重、装载八卡显存,再完成初始化与预热,服务恢复耗时 16 至 17.5 分钟。同组硬件上,L1 唤醒约为 4 秒。在本次实测中,与传统 NFS 冷启动相比,GPUWorks 分时复用通过 L1 唤醒,将模型服务恢复效率提升了 200 多倍。

04 / USE CASES
四种典型的 GPU 分时复用场景
场景一|模型选型与测试
给企业内部的 AI 助手选模型,研发需要让 DeepSeek、Qwen 和 GLM 各答一遍同一套问题,再逐题比较。三个模型可以先后运行,但如果每换一个模型都要找人停服务、重新部署,一套测试做下来,时间很容易花在等机器上。
在给研发安排的测试时段内,可以把三个候选模型都设为按时自动出让,每轮最长服务时间设为 120 秒,交接时选择等待当前请求完成。
这样,DeepSeek 本轮到时,可以在配置的等待上限内答完手上的问题,再交给排队的 Qwen,随后轮到 GLM。测试程序按模型分别记录回答。最后拿来比较的是同一套题、同一组硬件上的三份结果,一组 GPU 就能完成这次选型。
场景二|白天在线,夜间跑批
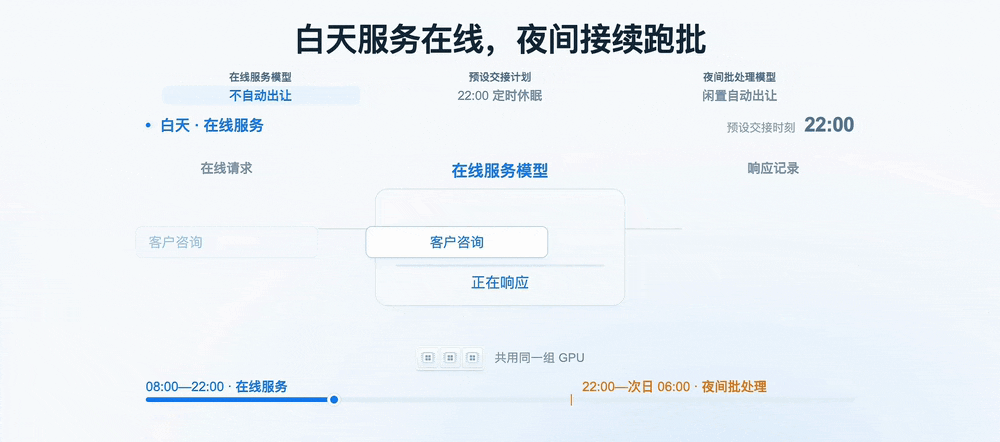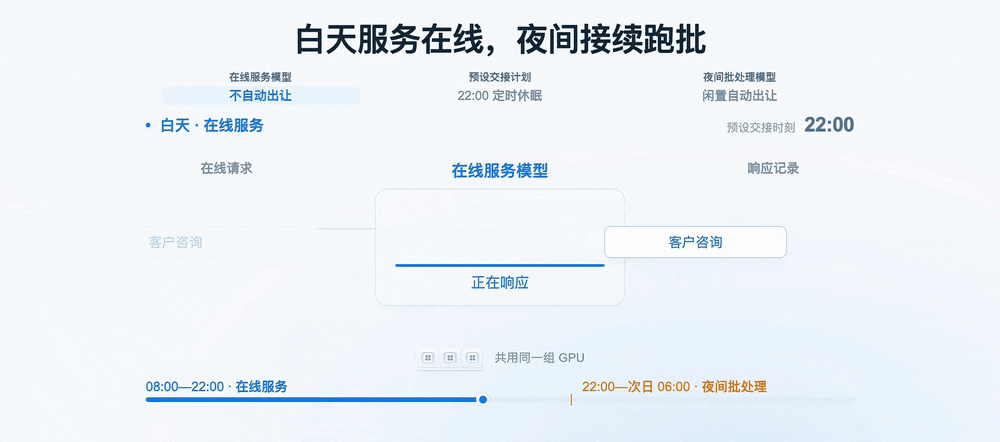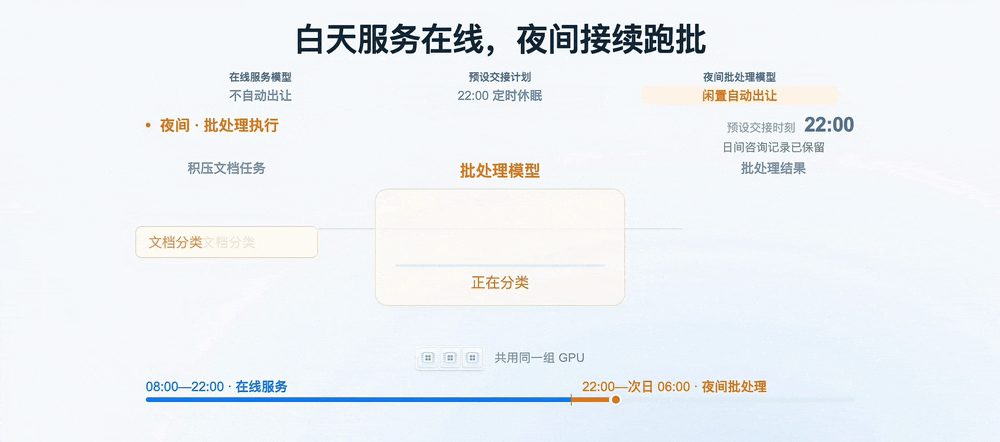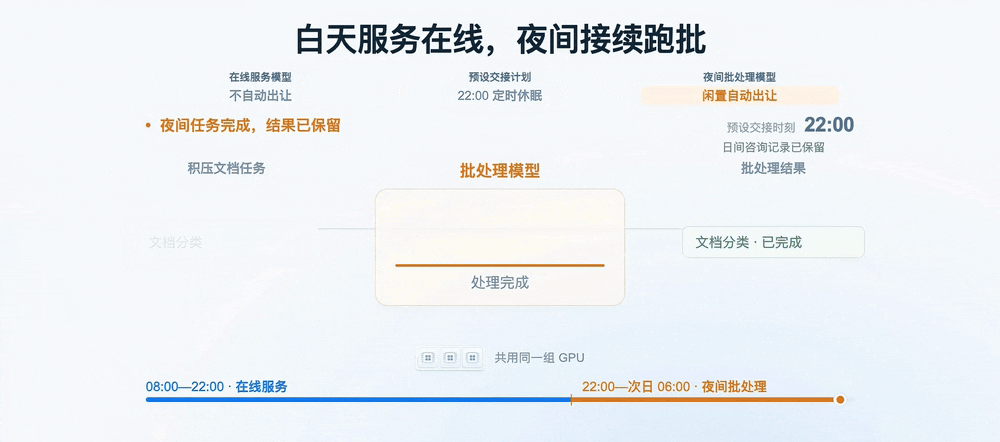
开头那组八卡有一个明确的交接时刻。在 GPUWorks 里,管理员给在线模型配置不自动出让,再到“定时计划”中添加休眠指令,选好执行的周期、释放资源的时间和休眠级别。这样,即使已有一批文档排队,在线模型也会继续响应查询。
到了约定时间,休眠指令生效,等待中的批处理模型即可接手这组卡。
批处理模型也可以另配闲置自动出让。如果某晚文档少,任务提前做完,只要闲置达到阈值、另有其他模型再等卡,剩下的夜间时段就能继续给其他任务使用。
场景三|关键业务优先用卡
有些请求等不到晚上十点。比如普通模型正在整理一批资料,关键业务的问答请求随时可能进来。如果专门为关键业务模型留一组卡,没人提问时卡就一直空耗;如果让它排在整批资料后面,又可能错过响应时机。
可以把关键业务模型作为 P0 优先级,可以配置闲置自动出让;把普通业务模型作为 P1 优先级,可以配置随时出让。普通业务平时照常工作。
关键请求到来时,普通业务模型按预设的交接规则收尾,例如在等待上限内完成当前这份资料、保存结果,然后让出 GPU。关键模型接手,优先回答这次提问。
关键模型答完问题后,如果连续 60 秒没有收到新的用户请求,而且资料整理模型仍在等卡,关键模型就会按闲置自动出让策略把这组 GPU 交回给资料整理模型。资料整理模型接着处理下一份资料。
场景四|两个积压队列持续轮用
离线数据合成要生成一批问答样本,文档摘要也排着一长串任务。两项工作优先级相同,都能分条处理。等样本全部生成才开始做摘要,意味着第一份摘要也要跟着等完整个队列。
这时可以给两个部署设置相同优先级,都选按时自动出让,每轮最长 120 秒。只要对方还有任务在等,当前模型用满一轮、按规则处理完手上的请求,就轮到对方。
合成程序逐条保存样本,摘要程序逐份保存结果,下一轮各自从待处理项继续。即使两边的队列一直都不空,当天也可以陆续拿到两类产出。如果其中一边先做完,另一边可以接着跑,无须为了一个已经清空的队列定时停下来。
决定是否增购 GPU,先看各项业务是否需要同时用卡。多个模型同时满载,算力仍要按峰值准备。用卡时段能够错开,GPUWorks 分时复用就能让同一组 GPU 承接更多工作。
05 / COMMUNITY
加入社区
GPUWorks 的开源之路才刚刚开始。无论你是 AI 开发者、基础设施工程师,还是硬件厂商,都欢迎参与进来,尝试不同的模型与算力组合,分享使用经验,反馈问题,与我们一起完善 GPUWorks。
体验 GPUWorks,参与开源共建!
