


背景
GPUWorks 的推理模板已经在 Day 1 已经支持 MiniMax-H3-Image!部署后,用户可以再试验场可以直接文生图和改图,也可以通过 OpenAI 兼容的 /v1/images 接口调用。
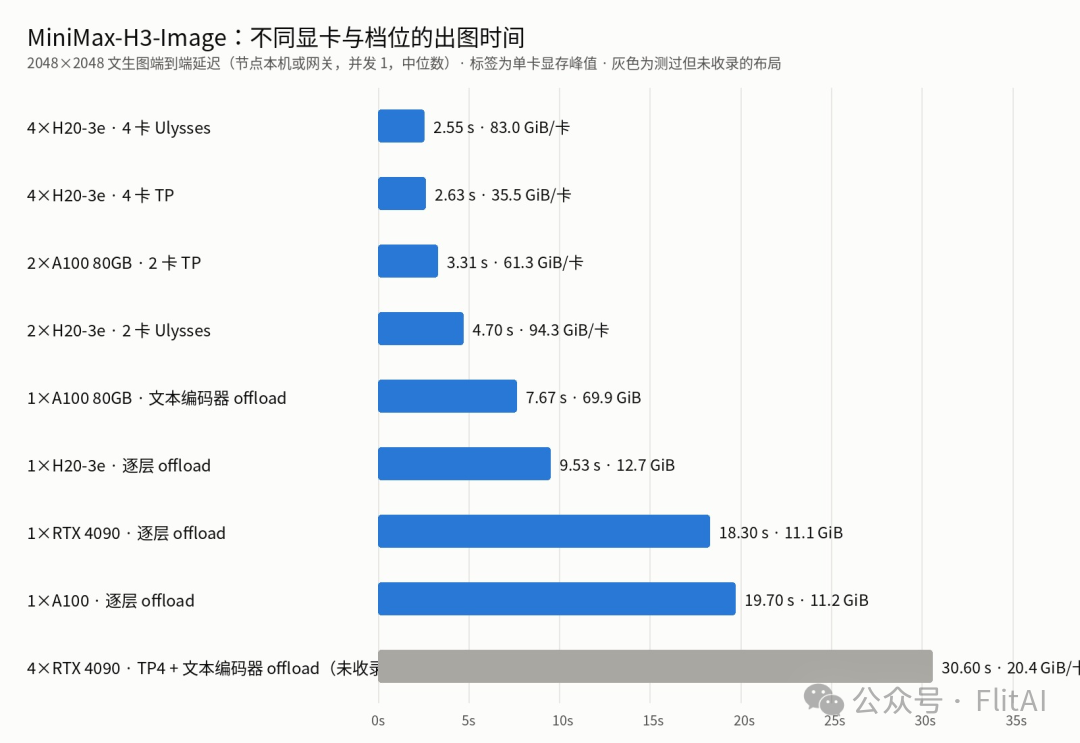
我们按不同的使用门槛准备了 6 个档位,并分别在 RTX 4090、A100 80GB 和 H20-3e 上实测:
一张 24 GB 的 RTX 4090 就能跑,每张 2048×2048 的图约 18 秒。
两张 A100 约 3.3 秒。
四张 H20 约 2.6 秒。
MiniMax-H3-Image 是 MiniMax 开源的文生图与参考图编辑模型,建立在 MiniMax-H3 的 DiT 上:
组成:33.1B 的 DiT(BF16)、33.4B 的 Qwen3-VL 文本编码器(BF16)、0.58B 的图像 VAE(FP32),权重合计约 135 GB。
每张图固定 6 步,模型做过 CFG 蒸馏。
编辑最多接受 9 张参考图。
原生画布是 2048² 级别,最大可以出 4736×3552。
上游由 vLLM-Omni 提供服务,配方见 vLLM recipe。
02 / TEST ENVIRONMENT
测试环境
我们用三类硬件覆盖从入门到高性能的场景。其中两台是在 GPUWorks 的「公有云」页面直接租的云主机,租好后一键装上 agent,几分钟就作为节点上线:
左右滑动查看完整表格
模型:
MiniMaxAI/MiniMax-H3-Image(68.7 GB)加MiniMaxAI/MiniMax-H3的text_encoder目录(66.7 GB),两者都固定了 revision。镜像:
vllm/vllm-omni:minimax-h3-image,上游随模型发布,包含 vLLM 0.33.0、vLLM-Omni 和 PyTorch 2.14 + cu130。
03 / MODEL TEMPLATE
模板:两个组件,一处改写
MiniMax-H3-Image 的仓库里没有文本编码器。它的 model_index.json 写的是「去 Hugging Face 上的 MiniMaxAI/MiniMax-H3 取 text_encoder」。而 GPUWorks 启动引擎时默认离线(HF_HUB_OFFLINE=1),很多节点也连不上 Hugging Face。所以模板把它拆成两个组件:
MiniMaxAI/MiniMax-H3-Image | /models/MiniMax-H3-Image | |
MiniMaxAI/MiniMax-H3text_encoder | /models/MiniMax-H3 |
下载和挂载:两个组件都由平台下载并挂载进容器。每个组件同时声明了 Hugging Face 和 ModelScope 两个来源,节点访问哪个快就用哪个。
启动前改写:引擎启动前,模板的启动前脚本在
/tmp下用软链接拼出一个模型目录,把model_index.json里的仓库名换成挂载路径。vLLM-Omni 发现这是本地目录,就直接加载,不再访问 Hub。固定 revision:Hugging Face 仓库在发布后又加了一份 diffusers 格式的权重,整个仓库涨到约 204 GB,vLLM-Omni 用不到这份。模板固定在加入它之前的 revision,与 ModelScope 的版本逐文件核对过,sha256 一致。
04 / DEPLOYMENT OPTIONS
6 个档位
档位参数取自 vLLM recipe,再按实测调整了适用的卡型和显存预留:
「适用」是模板的匹配条件,实测过的卡型见下文「性能」一节。
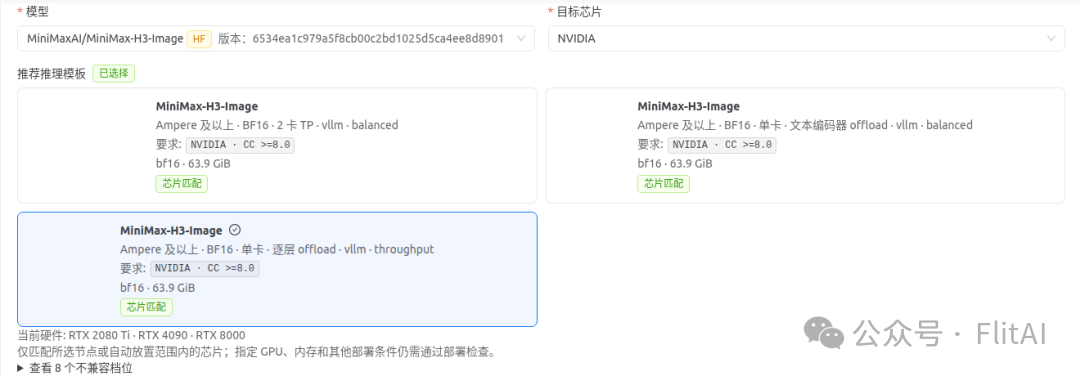
部署表单先按卡的架构筛选档位。下图是集群里有 RTX 4090 时的情况:三个 Ampere 档位显示「芯片匹配」,Hopper 档位归入「不兼容档位」。选好节点后,平台再按每个档位的单卡显存下限做放置检查,所以在 4090 上只有「单卡 · 逐层 offload」能部署:
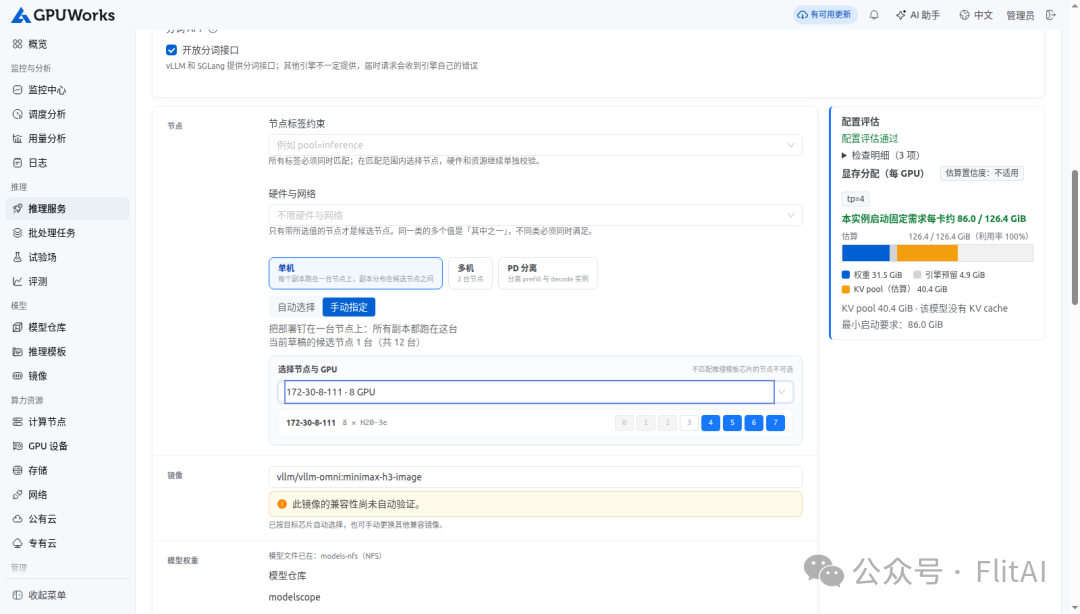
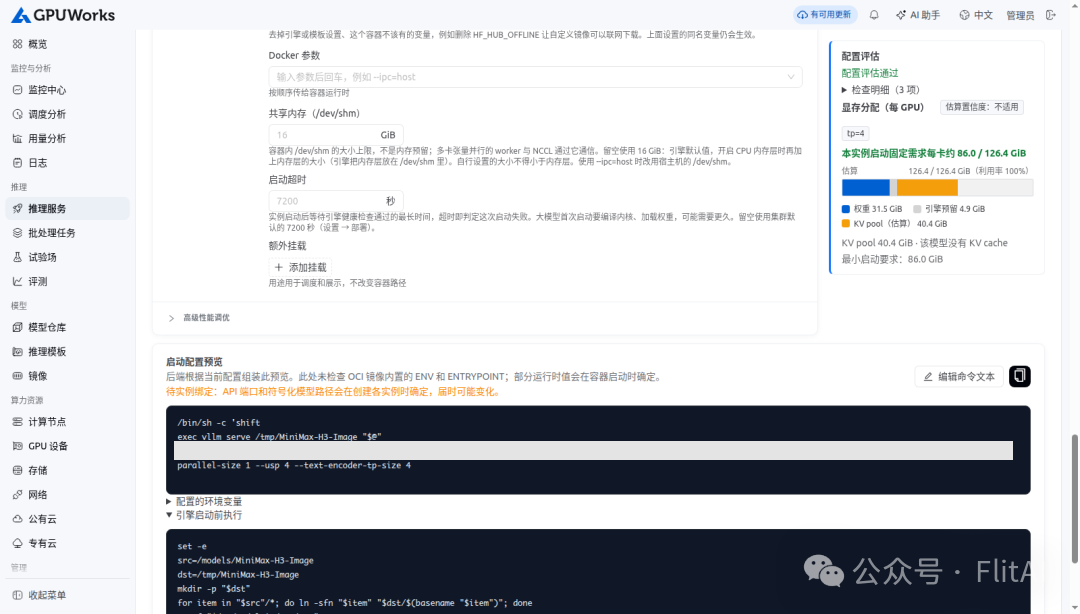
在 H20 上选 GPU 部署时,右侧「配置评估」按档位声明的需求检查每卡显存,「启动配置预览」给出平台真正执行的命令。--served-model-name、端口这些参数都由平台注入:
05 / IMAGE PLAYGROUND
试验场:文生图与编辑
部署就绪后,「试验场 → 图片」里就能选到这个模型。模板为它同时声明了「图片生成」和「图片编辑」两个接口,页面上可以切换。
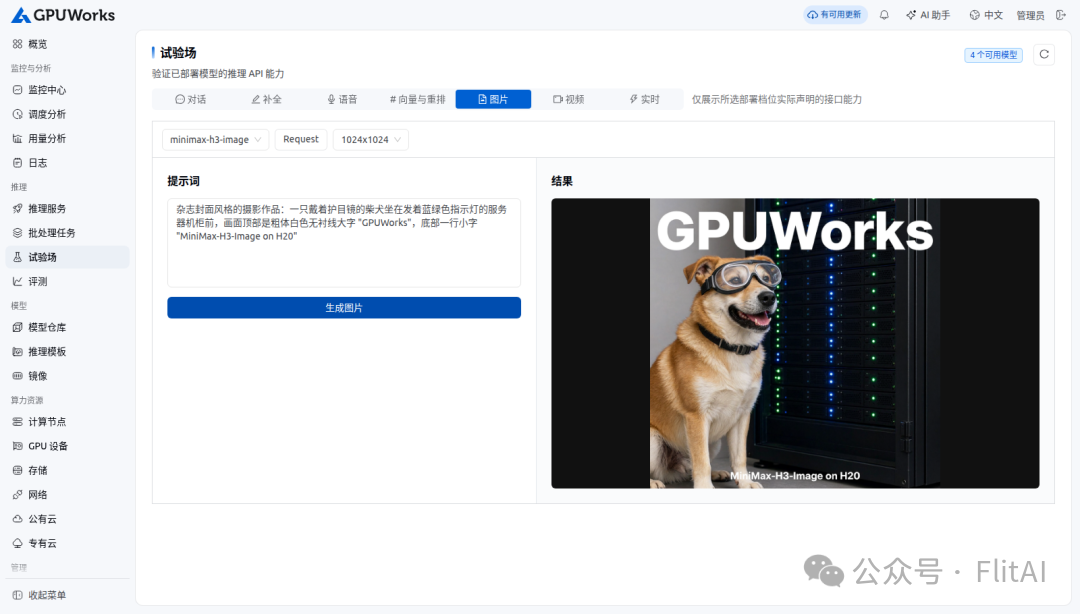
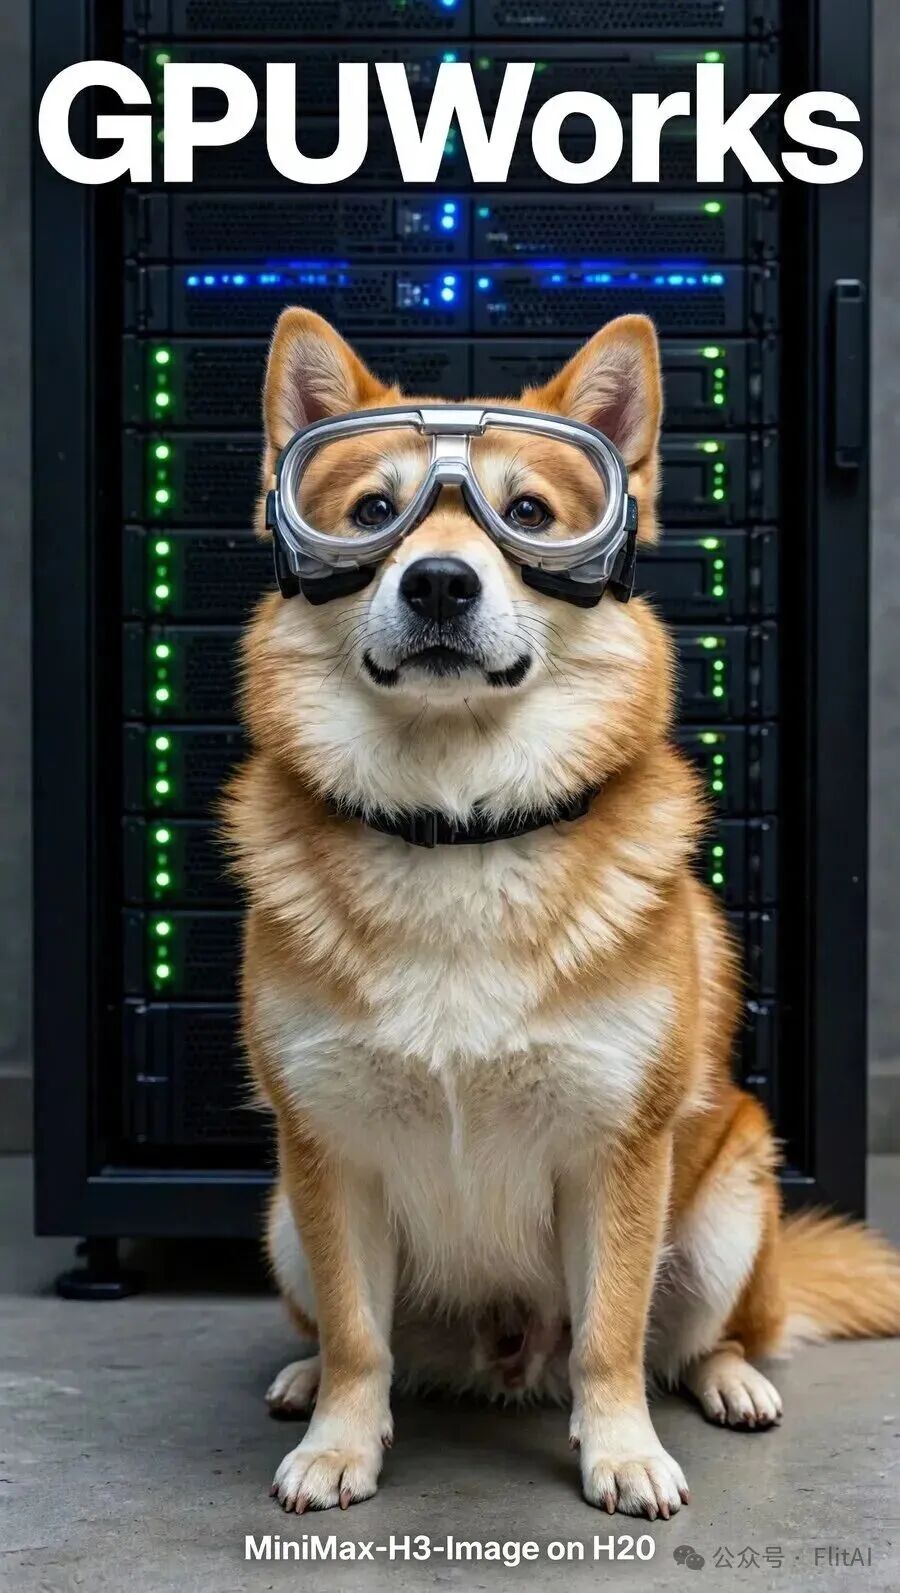
文生图:提示词要求在画面里写出指定文字,模型把 "GPUWorks" 和底部小字都写对了。在 4 张 H20 上,从点击到出图约 2.9 秒:
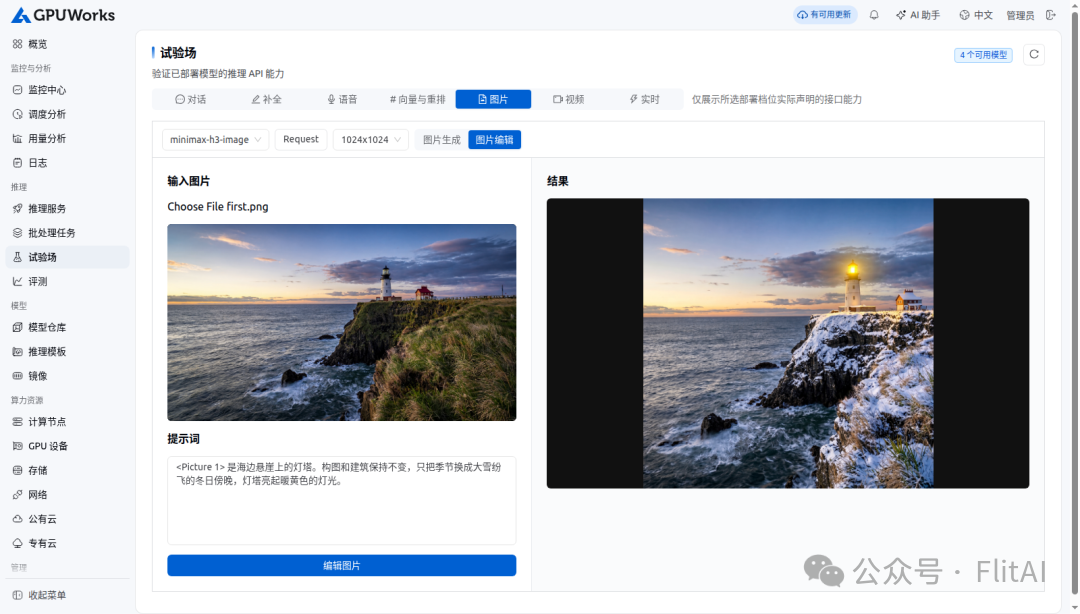
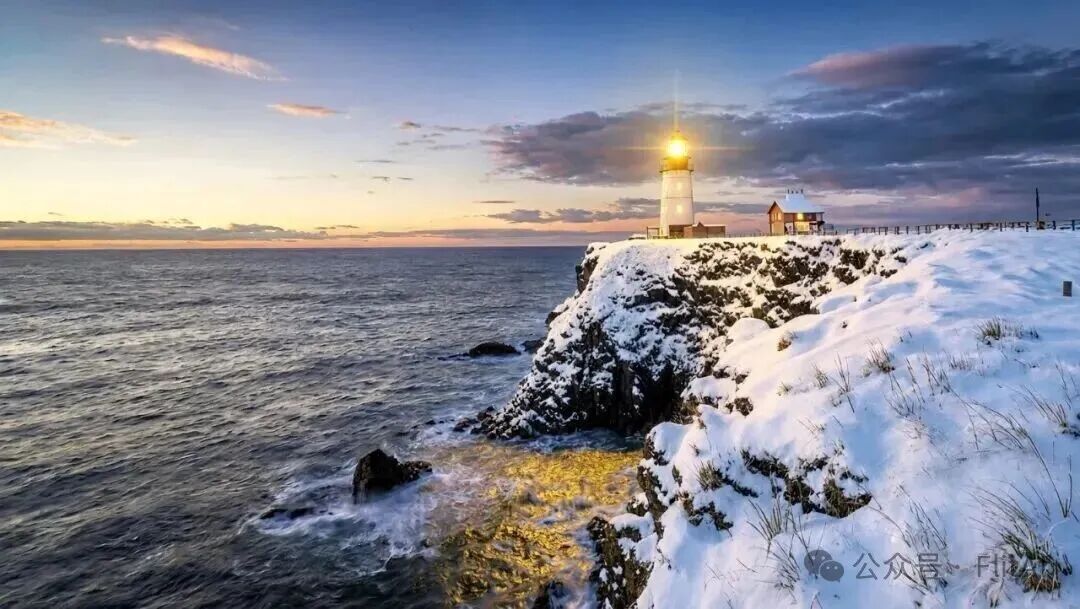
图片编辑:上传一张灯塔照片,只要求把季节换成冬天,构图、灯塔和小屋都保留了下来:
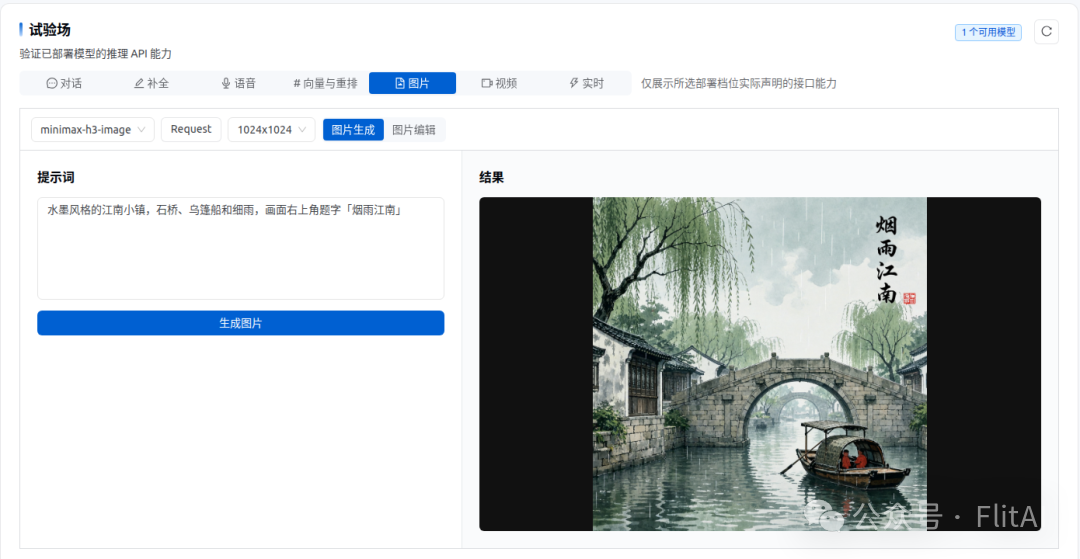
换成一张 RTX 4090(单卡 · 逐层 offload),同一个页面照样能用。下图是在 4090 上生成的一张带题字的水墨画,引擎出图约 17 秒,加上把图传回浏览器,从点击到出图约 30 秒:
同样的请求也可以走平台的 OpenAI 兼容网关,用平台签发的 API 令牌调用:
curl http://<server>/v1/images/generations -H "Authorization: Bearer $TOKEN" \  -H 'Content-Type: application/json' \  -d '
{"model":"minimax-h3-image","prompt":"…","size":"2720x1536","seed":42,"response_format":"b64_json"}'
几张生成的原图(缩小展示)。2720×1536 文生图:
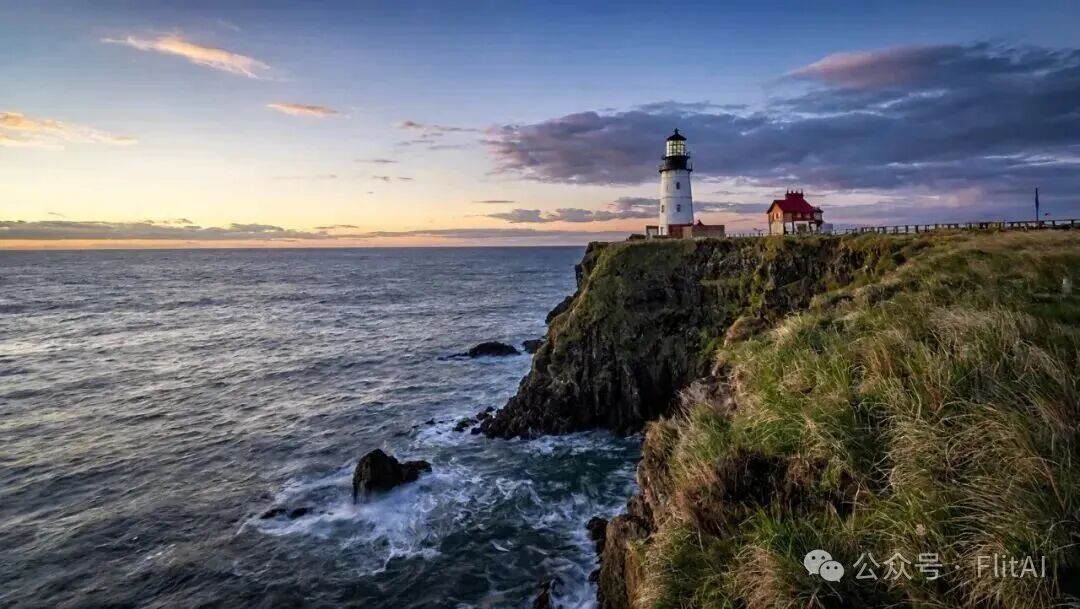
以上图为参考图,2720×1536 编辑:
1536×2720 竖版海报:
06 / PERFORMANCE
性能:不同显卡和档位
压测用固定并发的闭环请求,同时每 0.5 秒采一次 nvidia-smi,记录显存和功耗。
H20 的请求经平台网关发出;云主机的请求直接打到节点上的引擎,以排除跨地域网络的影响。
平台的「评测」目前只能压对话接口,图片接口用的是自写脚本,和数据一起放在证据目录。
全部请求都成功,表中是并发 1 时端到端延迟的中位数:
左右滑动查看完整表格
编辑一列:H20 用 2720×1536 的参考图,A100 和 4090 用 2048×2048 的参考图,两者不完全可比。
从这些数据能看出几点:
1024² 和 2048² 一样快。小于 2048² 的请求会先在 2048² 的画布上生成,再缩小回去,要更清晰的图不用多花时间。
并发不增加吞吐。4 卡 Ulysses 在并发 1、2、4、8 下吞吐都是 0.41 张/秒,延迟随并发线性增长,并发 8 时 19.3 秒。引擎一次只处理一张图,多出的请求只是在排队。要提高吞吐,就多部署几个副本。
H20 上 4 卡 TP 更划算。比 Ulysses 只慢 3%(2.63 秒对 2.55 秒),每卡显存却从 83 GiB 降到 35.5 GiB,省下的显存可以留给其他服务。
一张 4090 就能跑。逐层 offload 把 DiT 和文本编码器都放在锁页主机内存里,每层用到时再拷上卡,显存只要 11 GiB。代价是主机内存,需要约 124 GiB。
逐层 offload 的速度看 PCIe,不看算力。同一个档位,H20(PCIe 5)9.5 秒,4090 和 A100(PCIe 4)18–20 秒。
消费级卡不适合多卡。4090 之间没有 NVLink,跨卡通信都要经过主机。我们也试了两种多卡布局:4 卡 TP 加文本编码器 offload 每张 30.6 秒,2 卡 Ulysses 加逐层 offload 每张 110 秒,都比单卡慢,所以没有放进模板。想在 4090 上提高吞吐,就每张卡部署一个单卡副本,主机内存按每个副本约 124 GiB 准备。
两张 A100 已经很快。2 卡 TP 每张 3.3 秒,和四张 H20 差距不大。只有一张 80 GB 卡时,文本编码器 offload 每张 7.7 秒。
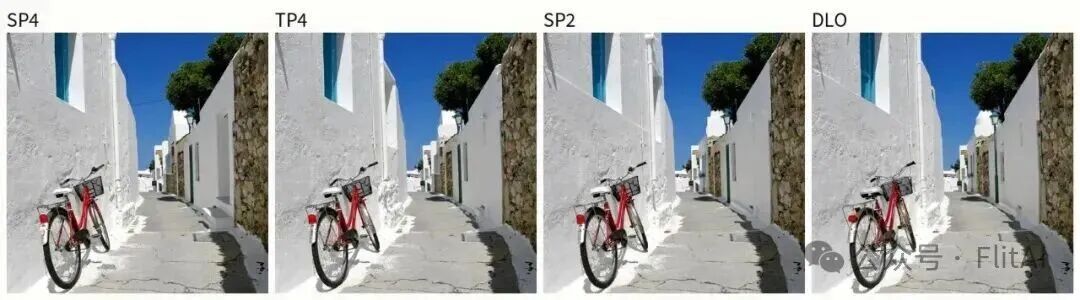
同一 seed,不同档位,出图几乎一样。下面是 4 卡 Ulysses、4 卡 TP、2 卡 Ulysses 和逐层 offload 用同一 seed 生成的图:
显存预留:每个档位声明的显存预留都高于实测峰值。平台给 omni 引擎的可用显存按卡的 90% 计算,80 GB 卡只算 72 GiB,所以单卡文本编码器 offload 的预留定在 71.5 GiB,正好放得下。
启动时间:4 卡 H20 从共享存储冷启动约 4 分钟,权重在页缓存里时约 1.5 分钟。两个 offload 档位要先把权重搬进锁页内存,需要 5–8 分钟。
07 / OBSERVABILITY
监控
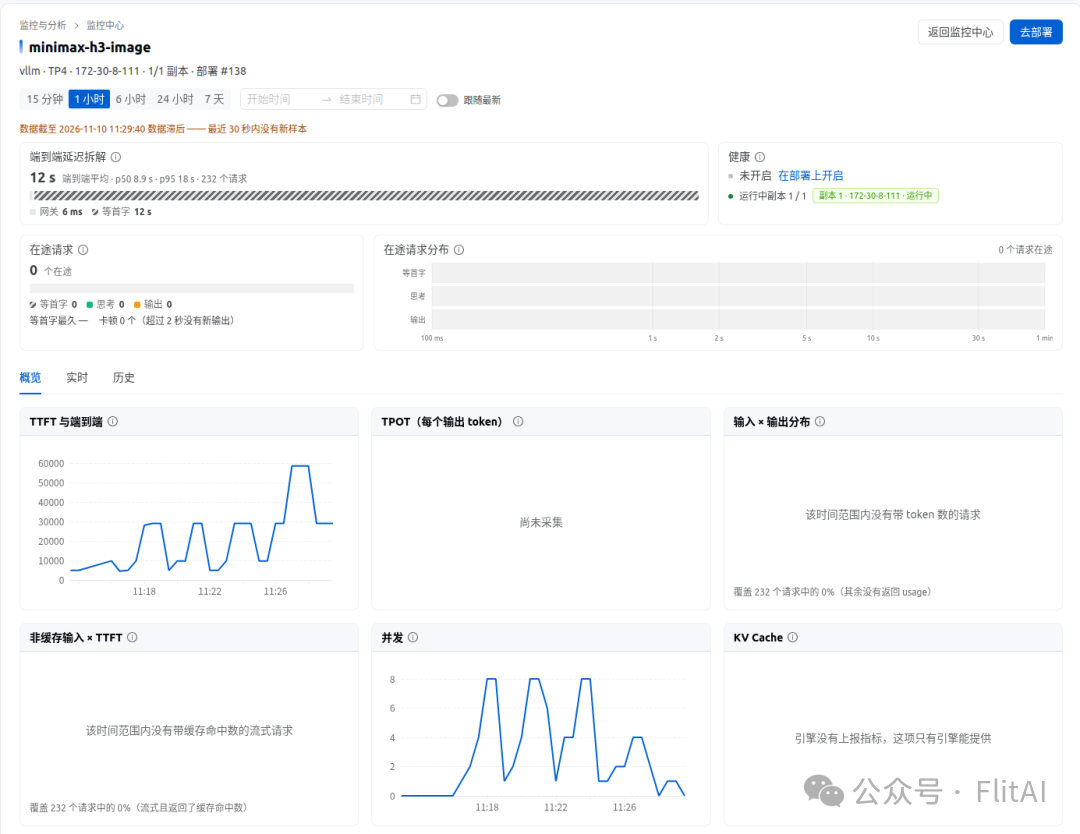
不用另外部署 Prometheus 或 Grafana,网关自己就会统计每个请求。
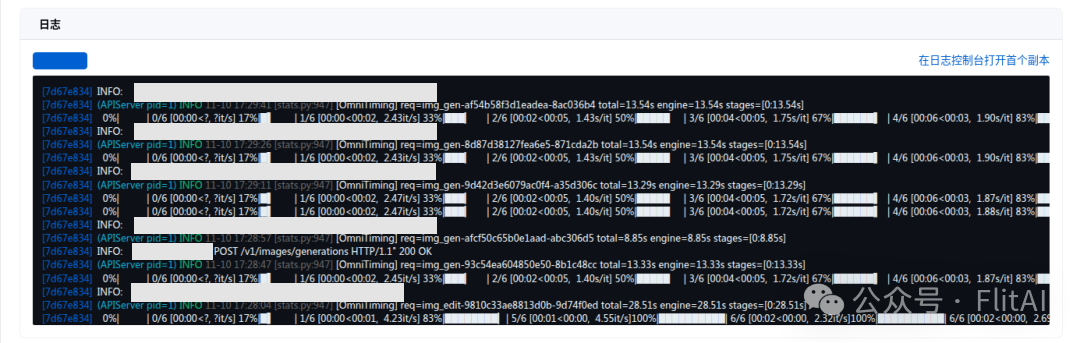
服务监控页显示压测期间的请求数、端到端延迟、并发曲线和网关开销(6 ms),下方实时滚动容器日志。vLLM-Omni 每处理一张图都会打一行 OmniTiming,记录总耗时和各阶段耗时:
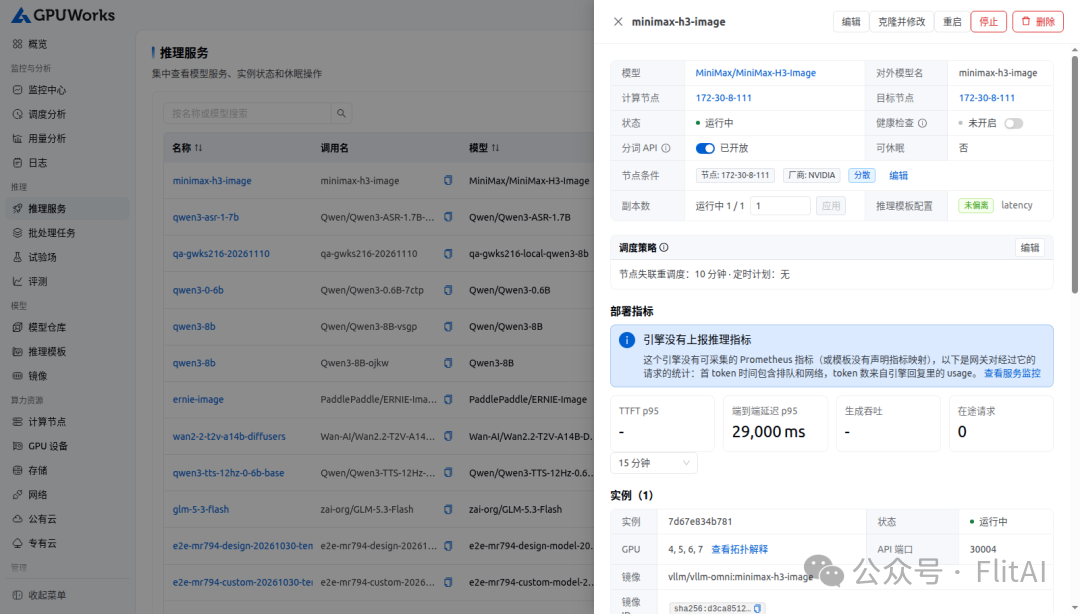
部署详情页把同样的统计放在「部署指标」里,并列出实例所在的 GPU 和镜像摘要:
08 / PLATFORM UPDATES
平台侧的改进
接入这个模型时,我们在平台 nighty 版本也做了几处行为的优化:
另外两个观察:
一张 2720×1536 的编辑在某个 seed 下输出过度锐化,季节也没有改,换一个 seed 就正常,原因还在收集样本确认。
服务监控里,图片请求的耗时目前被记在「等首字」名下,后续会改为按图片请求展示。
09 / FIELD NOTES
经验与建议
未来待上游更新后,我们会发布包含 MiniMax-H3-Image 的 GPUWorks vLLM-Omni runner 镜像,用它替代首发镜像,方便大家完全离线部署 MiniMax-H3-Image。欢迎大家加入我们的社区微信群,参与交流和讨论!
10 / COMMUNITY
加入社区
GPUWorks 的开源之路才刚刚开始。无论你是 AI 开发者、基础设施工程师,还是硬件厂商,都欢迎参与进来,尝试不同的模型与算力组合,分享使用经验,反馈问题,与我们一起完善 GPUWorks。
体验 GPUWorks,参与开源共建!
