


企业的 GPU 数量增加了,业务等待算力的情况却没有明显减少。
这正在成为不少 AI 基础设施项目的真实处境。早期采购的 NVIDIA GPU 仍在使用,国产 GPU 陆续进入数据中心,同一品牌内部又有不同代际和型号。
资源分散在不同服务器、集群和团队。有的 GPU 长期高负载,有的处于空闲;小型推理或开发任务占住整张卡,新的训练和推理任务仍然需要排队。
从采购台账看,企业"有卡";从业务感受看,可及时获得的算力依然不足。
真正值得企业关注的问题是:在继续采购 GPU 之前,现有资源是否已经被充分组织起来,并能按业务需要及时供给?
01 / WHY LOW UTILIZATION
GPU 很多,业务为什么还在等算力?
多品牌、多型号并存增加了资源管理的复杂度,但芯片种类本身并不会直接导致利用率低。问题通常出现在资源供给链条的三个位置。
第一种情况是资源位置与任务位置错配
不同品牌、项目或部门分别建设资源池,资源的所有权和使用边界长期固定。
一个资源池中的 GPU 已经排满,另一个资源池还有空闲,但等待中的任务无法直接使用。企业拥有的是多个局部资源池,而不是一个能够按照任务需求供给的整体算力池。
第二种情况是资源粒度与任务需求错配
大型训练、高并发推理需要整卡甚至多卡性能。开发调试、小模型推理、Embedding、Rerank 等任务往往只使用部分显存和计算能力。
如果平台只能整卡分配,任务申请到的资源规格会持续大于实际需求。卡已经被占用,剩余能力却无法交给其他任务。
第三种情况是监控与供给脱节
平台能够看到温度、负载和故障,并不代表空闲资源会自动回到可分配状态。
缺少配额、优先级、回收和计量规则时,GPU 仍然依赖人工分配。团队为了避免后续申请困难,往往倾向于长期占有资源,进一步放大闲置。
提升 GPU 利用率,需要把整条资源供给链衔接起来。
平台既要掌握资源的位置和状态,也要根据任务选择合适的交付方式,让释放的资源及时回到池中,再通过调度和运营规则持续供给。
02 / AIOS OVERVIEW
ZStack AIOS:让 GPU 利用率提升超 1.3 倍
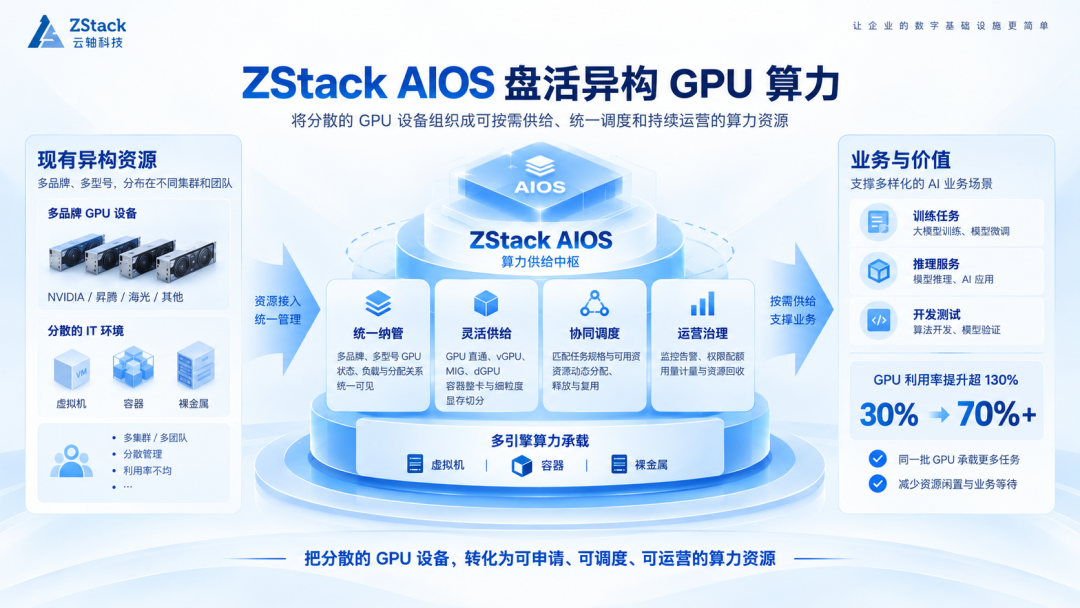
通过异构 GPU 统一纳管、按需切分、动态回收与协同调度,ZStack AIOS 智塔帮助企业将传统方式下约 30% 的 GPU 利用率提升至 70% 以上,提升超 1.3 倍。
同一批 GPU 可以承载更多训练、推理和开发任务,缩短业务等待算力的时间,也让已经投入的数据中心资产得到更充分的利用。
ZStack AIOS 智塔是一款面向企业的新一代 AI 基础设施操作系统。
针对多品牌、多型号 GPU 并存后出现的资源分散、整卡浪费和供给效率低等问题,AIOS 将资源纳管、GPU 虚拟化与切分、多引擎承载、分布式调度、监控运维和资源运营连接在同一平台中。
目前,AIOS 可覆盖多个 GPU 品牌、30 多种硬件形态,并具备上万张 GPU的统一纳管能力。
平台支持虚拟机、容器和裸金属多种算力承载环境,也提供 GPU 直通、vGPU、MIG、dGPU、容器整卡和显存切分等资源交付方式。
设备纳入平台后,管理员可以统一掌握 GPU 的型号、状态、分配关系和实时负载。
训练、推理或开发任务可以根据性能、隔离、弹性和运行环境要求获得合适的 GPU 规格与承载方式。任务释放的资源重新回到资源池,继续参与后续调度。
支撑这一提升的,是一套贯穿资源识别、规格供给、任务调度和日常运营的技术体系。
03 / UNIFIED VIEW
第一、把分散的异构 GPU 纳入同一套管理体系
AIOS 将分散的 GPU 纳入统一资源视图,集中呈现设备型号、状态、分配关系、负载、显存、温度和功耗,为资源分配和调度提供完整依据。
NVIDIA、昇腾、海光、阿里 PPU 等芯片保留各自的软件栈、驱动、算子和适配环境。AIOS 在兼容范围内统一管理这些资源,让管理员能够掌握不同资源池的使用情况,并为任务选择符合要求的算力。
设备状态和分配关系进入同一视图后,资源池之间的闲忙差异可以直接参与调度,空闲资源也能更快回到业务供给中。
04 / GPU PARTITIONING
第二、让一张 GPU 按照任务需要提供资源
统一纳管解决了"资源在哪里",提高利用率还要回答"任务应该拿到什么规格"。
AIOS 提供 GPU 直通、vGPU、MIG、dGPU 以及容器整卡和显存切分等方式,分别适配不同的性能、隔离、弹性和硬件条件。
GPU 直通
对大型模型训练、多卡推理或高性能计算,GPU 直通把物理设备交给虚拟机独占使用,减少虚拟化开销,适合优先保证原生性能的场景。此时整卡独占是合理选择。
vGPU 与 MIG
当业务需要强隔离或固定规格时,可根据 GPU 厂商与型号采用原生 vGPU 或 MIG。它们的授权方式、硬件支持范围和可切规格不同,平台可按实际设备条件提供合适选项。
dGPU(CUDA API 拦截转发)
对虚拟机中的 CUDA AI 负载,AIOS 的 dGPU 采用 CUDA API 拦截转发方式,在支持的 NVIDIA GPU 上按显存规格模板动态创建资源。虚拟机启动时获得所需显存,停机或卸载后显存即时归还资源池,不必提前把一张卡固定切成二分之一、四分之一或八分之一。
这种方式更适合开发环境、小模型推理、Embedding、Rerank 以及多项目共享等场景,可以减少长期整卡占用。
容器显存切分(粒度可细至 1%)
在支持的容器环境中,AIOS 还能进行细粒度显存切分,粒度可细至 1%,让一张物理卡同时承载多个实例。
选择哪种方式,取决于任务对性能、隔离、弹性和成本的真实要求。多种资源形态能够减少申请规格与实际使用之间的差额,让大型任务获得完整性能,也让轻量任务避免长期占用整张 GPU。
05 / SCHEDULING
第三、用多引擎和协同调度承接不同任务
切分能够释放卡内剩余资源,调度决定这些资源能否及时供给业务。
AIOS 在虚拟机、容器和裸金属多种承载环境之上,对资源状态与任务需求进行匹配。
原生性能任务:整卡或裸金属
需要原生性能的任务可以选择整卡或裸金属资源。
环境隔离与开发工具链:虚拟机
需要环境隔离、开发工具链或 Windows 生态的任务可以使用虚拟机。
弹性推理与快速交付:容器
弹性推理和快速交付场景则可以使用容器及相应的 GPU 资源配置方式。
在更大规模的环境中,分布式与协同调度可以结合资源可用状态、任务规格和优先级,把任务放到兼容且合适的节点或资源池中。
队列和优先级机制还可以帮助企业组织不同时段的负载,例如保障在线推理,再利用低峰时段承载训练或批处理任务。
异构调度围绕任务需求匹配兼容的资源。模型、驱动和软件环境仍按具体芯片条件完成适配,平台负责把任务放到符合要求的节点或资源池中。企业可以在统一体系中组织多种算力,同时保留不同芯片和负载所需的运行条件。
06 / GOVERNANCE
第四、用监控、配额和计量维持长期共享
GPU 共享进入生产环境后,资源治理会直接影响利用率。
监控与告警
AIOS 可统一查看物理 GPU、vGPU 和 dGPU 的分配与运行状态,并监控利用率、显存、温度和功耗。
管理员可以设置告警阈值,将消息推送至企业协作平台或 Webhook,并通过设备信息定位故障硬件。资源异常更快被发现,长期低负载设备也更容易进入回收与优化流程。
配额、权限与计量
多租户、权限、配额和计量进一步把共享规则固定下来。不同部门和项目获得明确的资源额度,平台记录使用情况,必要时结合审批和优先级安排稀缺资源。GPU 不再依赖人工"占卡"和临时协调,企业也能据此开展成本分摊与容量规划。
这部分能力决定了一套共享机制能否长期运行。缺少监控和运营约束,再细的切分也可能重新形成碎片。
07 / CUSTOMER CASE
客户实践:让已有算力持续进入实际业务
某省财经大学在建设 AI 智算平台时,已经拥有服务器、存储以及数十张 NVIDIA A40、NVIDIA L20。
不同课题和部门对算力的需求并不相同。部分任务需要整卡性能,教学实验和轻量应用更适合细粒度资源。
学校还需要实时掌握 GPU 状态与负载,通过标准推理 API 将模型能力接入校园应用。如何充分利用原有设备,同时满足多类业务的差异化算力需求,成为平台建设需要解决的核心问题。
AIOS 将原有服务器、存储和 GPU 纳入统一平台,按场景提供 GPU 直通、vGPU 和显存切分,并通过负载监控与告警提高资源运维效率。
在统一算力底座之上,平台以标准推理 API 支撑教学科研与校园应用,让存量资源从分散设备转化为可以持续交付的 AI 服务。
在下一轮 GPU 采购启动之前,先看清一件事:现有算力是否做到可见、可分、可调、可回收、可计量? AIOS 将分散的 GPU 设备转化为能够按任务需求持续供给的算力资源,帮助企业提高设备利用率、加快资源交付,并在多品牌、多型号长期并存的环境中厘清成本、持续运营。 如果您的数据中心也面临资源闲忙不均与业务排队同时发生,欢迎联系 ZStack。我们可以从现有资源、任务类型和供给方式入手,帮助您找到仍可释放的算力空间。
