

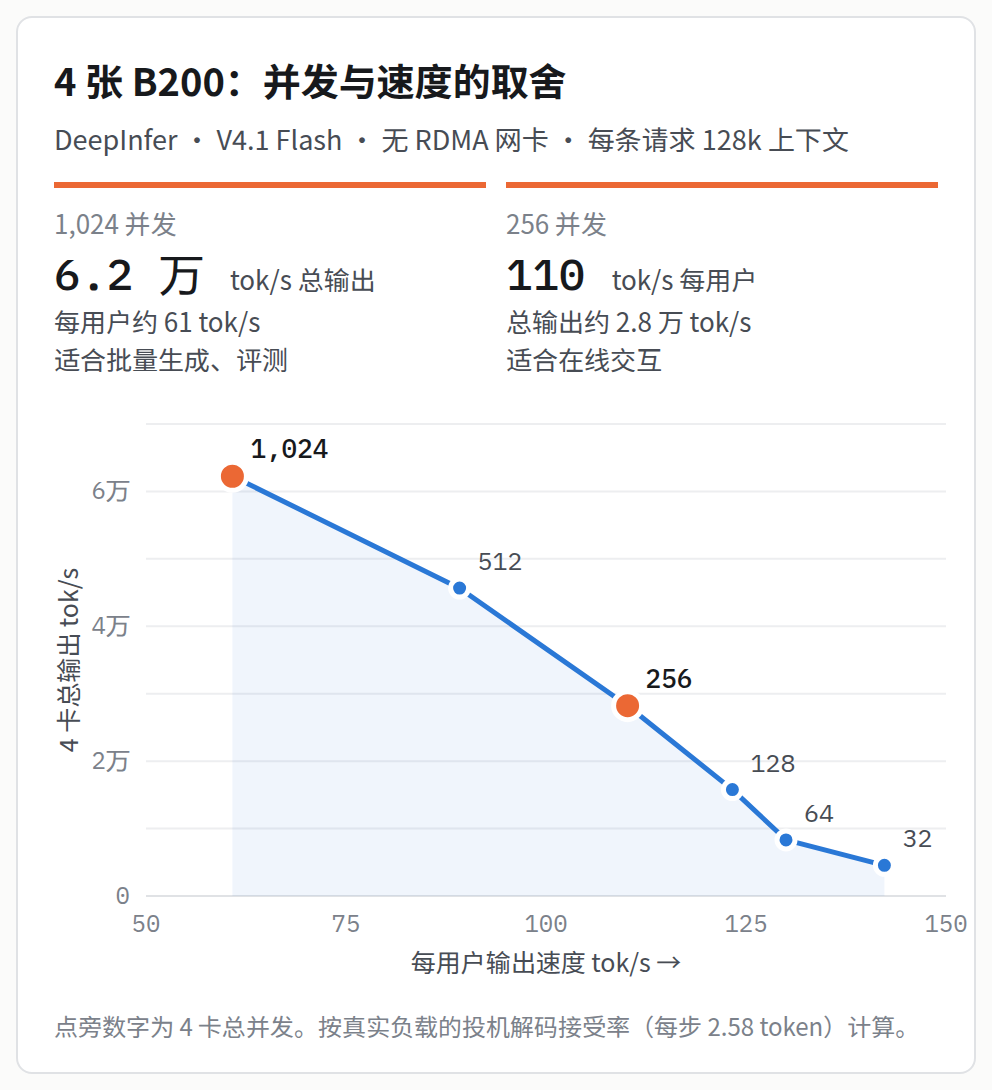
DeepSeek 昨天中开源了推理框架 DeepInfer,其公布的数据来自 8 卡和 64 卡集群,而且要求每台机器都有 GPUDirect RDMA 网卡。我们把门槛降到 4 张 B200、不要 RDMA 网卡。实测每条请求 128k 上下文、1,024 个并发请求下,4 卡总输出约 6.2 万 token/s,每个用户约 61 token/s;如果希望交互体验更好,限制 256 并发时每个用户约 110 token/s 。
背景
2026 年 10 月 20 日,DeepSeek 开源了支撑 V4.1 Flash 线上服务的推理框架 DeepInfer。官方 README 给出的性能是:整集群 64 张卡,每张卡 256 条请求,全集群约 1.6 万个并发,每条请求带 131,072 token(128k)上下文,nextn=3 投机解码,按 75% 接受率折算,每个用户约 103 token/s,每卡约 2.63 万 token/s,全集群约 168 万 token/s。
原方案对硬件的要求也很高。V4.1 的 Engram(n-gram 嵌入表)约 197 GB,按 rank 分片放在主机内存里,每一步前向都由 GPU 直接通过 RDMA 网卡去读,用的是 NCCL GIN / GDAKI。读本机的分片也要走网卡回环,没有 NVLink 或本地拷贝的路径。结果是:没有 InfiniBand / RoCE 网卡、或者网卡没透传进实例的机器根本启动不了,因此大部分容器云和大部分 GPU 虚拟机都无法使用。
我们的方案:EP4、去掉 RDMA 依赖
我们的目标是把门槛降到一台 4 卡 B200 就能跑:
4 卡 EP4:权重 510 GB,B200 每卡 183 GB 显存,4 卡放下权重后每卡还剩约 90 GB 给 KV cache 和激活。专家按 EP4 切分,attention 按 DP4 切分。 去掉主机 RDMA 依赖:用一个兼容接口的实现替换 Engram 的 RDMA 取数。表仍放在主机内存,各 rank 的分片拼进同一块共享内存,GPU 通过 PCIe 直接读。由一个环境变量开启,不开时完全走上游原路径。细节和正确性验证见文末附录。
测试机是一台 4×B200 容器实例(NVLink 全互联,驱动 595,2 TB 内存)。框架版本为 commit 774ce24,测试脚本用的是官方自带的 examples/benchmark.py、run_sweep.sh 和 eval/。
Decode 性能
测试配置与官方 decode 图一致:每条请求带 131,072 token 的上下文,nextn=3 投机解码,逐档增加每卡并发。官方图的纵轴先按"草稿全部接受"计步数,再乘以假设的每步平均 token 数 τ = 3.25(即每个草稿 75% 接受)。我们按同样口径换算,同时给出按真实负载接受率(τ = 2.58,来自下文 GPQA 测试)换算的结果。
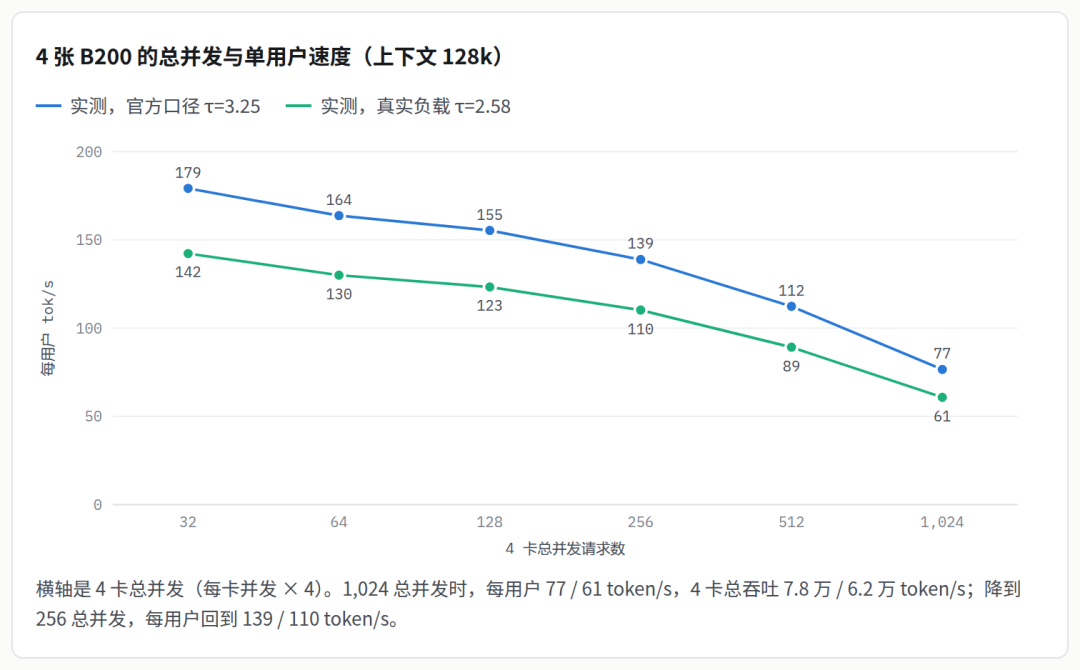
| 1,024 | 256 | 42.4 ms | 77 | 61 | 19,604 | 62,252 |
和官方数据放在一起看:官方 EP8、EP64 用了更多卡做专家并行,每张卡只需读更少的专家权重,所以同样每卡并发下更快。官方 EP8 在每卡 64 并发时每用户约 198 token/s,我们 EP4 是 139,约为它的 70%;每卡 256 并发时约 98 对 77。用 4 卡换来的是更低的部署门槛,代价是单卡吞吐少约 25%。
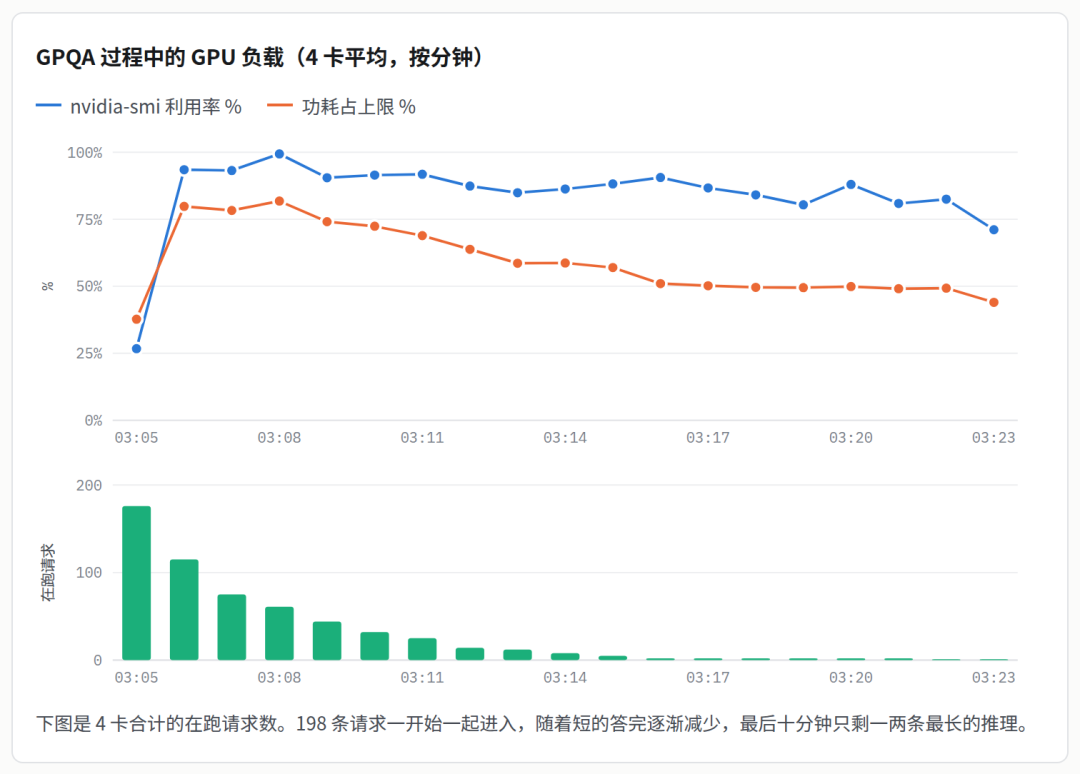
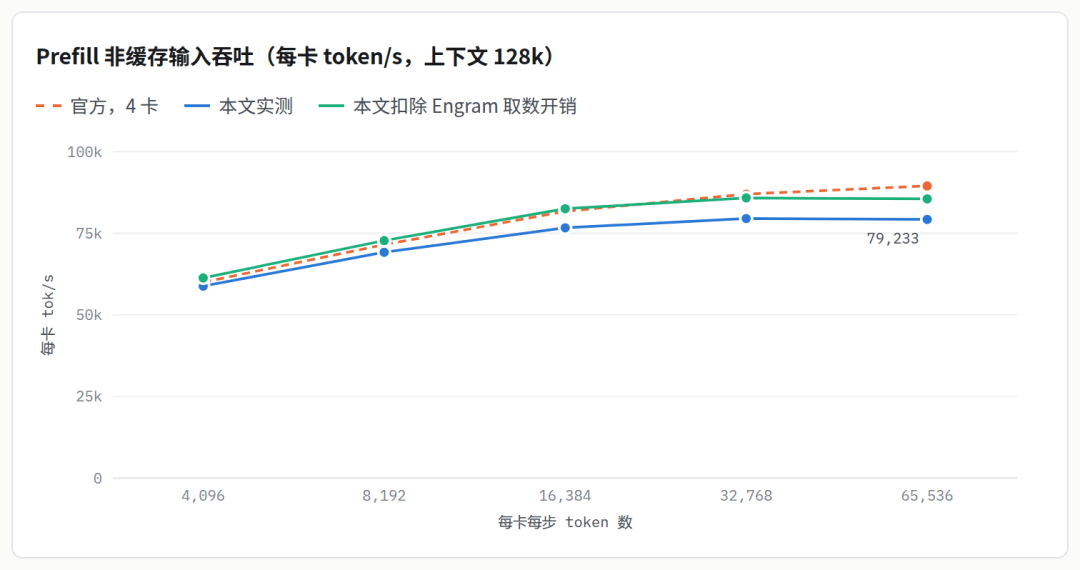
点旁数字为每卡并发。官方数值读自官方 README 和部署问答中的图,误差约 ±2%。 单请求延迟:同样 4 卡、32k 上下文,关闭投机解码时每步 7.6 ms,即 131.7 token/s。开启 nextn=5 投机解码后每步 11.2 ms,按真实接受率计算每用户约 230–250 token/s。在 AIME 测试最后只剩一条长推理时,实测单路约 304 token/s。 基准扫描使用合成输入。为了看真实推理负载,我们用官方评测脚本跑了 GPQA Diamond(198 题)和 AIME 2026(30 题),温度 1.0、最大思考强度,每题 1 次采样。 两项都在长思考下全部正常结束,没有截断。GPQA 共生成 310 万 token,4 卡平均约 2,900 token/s;平均值被最后只剩一两条长推理的十来分钟拉低了,见下一节。投机解码在真实负载上每步约出 2.6–2.8 个 token,比官方作图假设的 3.25 低约 20%,所以上面给了两种口径。 测试全程每 5 秒用 nvidia-smi 采一次利用率、功耗和频率。B200 的功耗上限是 1000 W,SM 频率全程稳定在 1965 MHz,没有降频。 结论:要把 4 张 B200 用足,需要足够的并发。上面的扫描显示每卡 64 条(总 256)时每用户仍有 100 token/s 以上;加到每卡 256 条(总 1,024),总吞吐还能再涨一倍以上,代价是单用户速度降到 60–77 token/s。 官方 prefill 曲线本来就是 4 卡测的,我们用完全相同的配置原样复现。实测比官方低 2–11%,batch 越大差得越多。原因是我们的 Engram 取数改为同步的 PCIe 读:65,536 token 时每步要多花约 61 ms,而上游的取数是异步发出、与前面层的计算重叠的。扣除这部分开销后,与官方的差距在 -1.3% 到 +2.2% 之间,最大 batch 一档差 4.4%。 为了方便复现,我们把编译好的 DeepInfer(commit 774ce24)和全部算子、Engram 本机取数补丁、测试脚本打成了镜像。权重不打进镜像,首次运行时下载到挂载目录。 镜像入口还提供 V4.1 的两张 Engram 表共 7.68 亿行,每行 256 B(FP8),合计约 197 GB,另有约 6 GB 缩放因子。上游在 NVIDIA 上默认把表按 rank 分片放在主机内存;每次前向时,DeepEP 的 代价是取数从"网卡读远端内存、与计算重叠"变成"PCIe 读本机内存、同步执行"。单卡实测随机 256 B 行的读取约 13 GB/s:decode 每步只取几百个 token,耗时不到 0.1 ms;prefill 在 65,536 token 时每步约 61 ms。这个方案只适用于单机,跨机仍需上游的 RDMA 路径。 新的取数路径必须和原来逐字节一致。我们用了三类检查: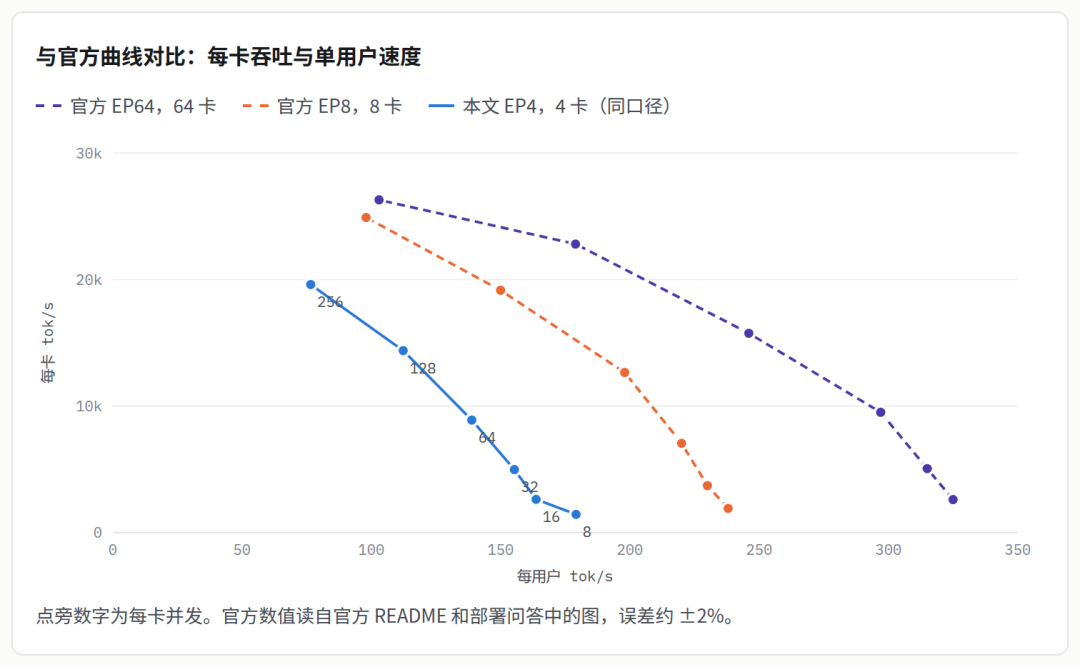
真实负载:GPQA 与 AIME
GPU 被用满了吗
Prefill
容器镜像
docker.io/zstackai/deepinfer:774ce24-r1quay.io/zstackai/deepinfer:774ce24-r1swr.cn-southwest-2.myhuaweicloud.com/zstackai/deepinfer:774ce24-r1# 1. 下载权重(510 GB)docker run --rm -v /data/models:/models zstackai/deepinfer:774ce24-r1 download# 2. 没有 RDMA 网卡的单机:打开本机取数补丁,/dev/shm 需约 400 GBdocker run --rm --gpus all --network host --ipc host \ --ulimit memlock=-1 --ulimit stack=67108864 \ -e DEEPINFER_ENGRAM_LOCAL_FETCH=1 -e EP_DISABLE_GIN=1 \ -v /data/models:/models -v /data/out:/out \ zstackai/deepinfer:774ce24-r1 selfcheck # 官方正确性测试# 3. 复现本文的 decode 扫描(每卡并发 8 → 256,上下文 128k)docker run ...同上... zstackai/deepinfer:774ce24-r1 \ sweep decode ep4-decode-128k 131072 3 0.75# 有 GPUDirect RDMA 的机器:去掉两个 -e,加 --privileged,即走上游原路径preflight(检查 GPU、RDMA 和权重)、offline、bench、eval 和 all(完整测试队列)。DeepInfer 开源版没有 HTTP 服务,镜像也只提供离线推理与测试。镜像里的依赖版本和补丁与本文实测环境一致,但镜像本身还没有在 GPU 上完整跑过一遍。附录:去掉主机 RDMA 依赖做了什么
1. 问题在哪
engram_fetch 内核在 GPU 上直接发起 NCCL GIN 读请求,经 RDMA 网卡把每个 token 需要的行取进显存。这个内核只有 GIN 一条路径。设置 EP_DISABLE_GIN=1 只能跳过初始化时的检查,第一次前向就会报非法地址。2. 替代实现
cudaHostRegister,得到 GPU 可以直接访问的地址(UVA)。index_select,按全局行号读取;缩放因子按 DeepEP 的列主序、4 元素对齐布局输出。形状固定,可被 CUDA Graph 捕获,不需要集合通信。set_config / write / fetch / destroy,在 userbuffer.allocate_engram 里由 DEEPINFER_ENGRAM_LOCAL_FETCH=1 切换。3. 顺带修掉的部署问题
pciutils(lspci 判断平台)和 libdw-dev。ibstat 探测网卡带宽,探测不到会直接报错,单机也会触发,需要安装 infiniband-diags。FLASH_MLA_SKIP_REG_SPILL_CHECK=1。4. 正确性检查
tests/models/test_offline_inference.py:在 4 卡 EP4/CP2 上生成,与仓库里 NVIDIA 4 卡的 PPL 基线逐样本比较
